



Yapay zekâ sektöründe modeller arasındaki rekabet yeni sürümlerle hız kazanırken, xAI bu kez Grok ailesinin 4.7 sürümünü kullanıcıların karşısına çıkardı. 21 Eylül 2026’da duyurulan Grok 4.7, yalnızca sorulara yanıt veren bir sohbet modeli olarak değil; saatler sürebilen kodlama, doküman hazırlama, terminal kullanımı ve çok aşamalı profesyonel iş akışlarında görev üstlenebilecek bir sistem olarak konumlandırılıyor.
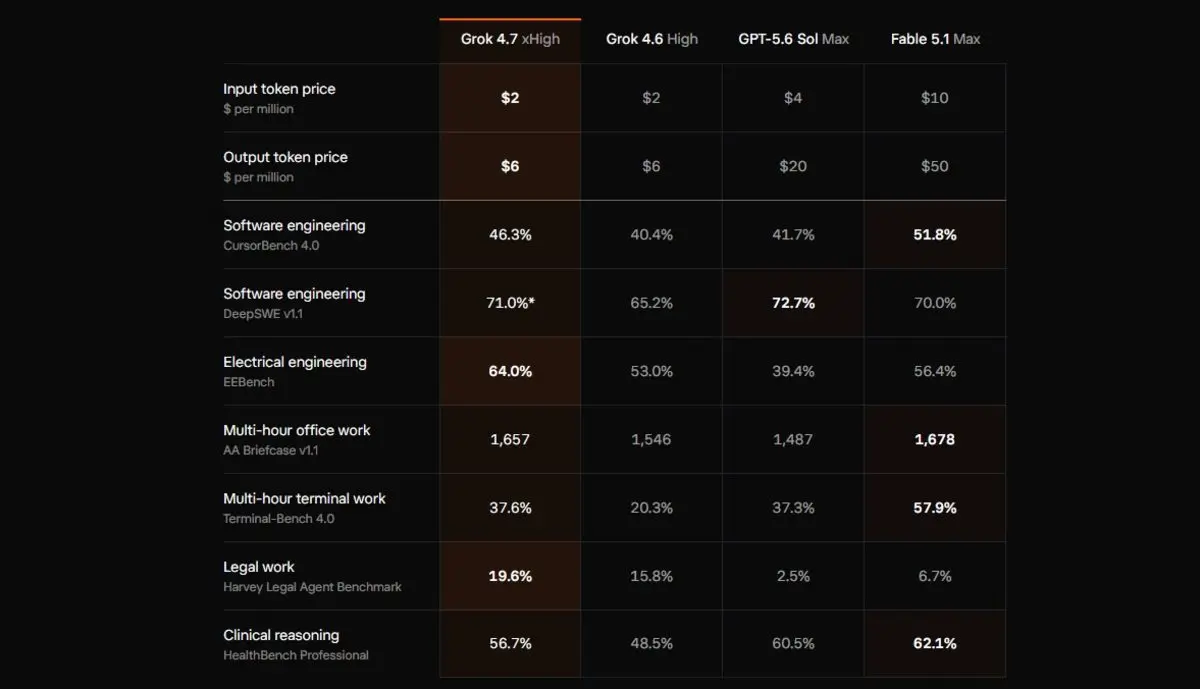
Modelin dikkat çeken taraflarından biri ise fiyatlandırma oldu. xAI, Grok 4.7’nin API tarafında milyon giriş tokenı için 2 dolar, milyon çıkış tokenı için 6 dolar ücretlendirme ile sunulduğunu açıkladı. Böylece temel fiyatlandırma Grok 4.6 ile aynı kaldı. xAI ayrıca belirli platformlarda daha hızlı çalışan Grok 4.7 Fast seçeneğini de sunuyor.
Grok 4.7 neden geliştirildi?
xAI’nin yeni modeldeki temel yaklaşımı, kısa sorulara daha hızlı yanıt vermekten ziyade uzun ve karmaşık görevlerde modelin daha fazla süre çalışabilmesi üzerine kuruluyor.
Şirketin açıklamasına göre Grok 4.7, Grok 4.6’ya kıyasla daha büyük yeni bir temel model kullanıyor. Eğitim sürecinde daha uzun bir pekiştirmeli öğrenme aşaması uygulanan sistem, özellikle tamamlanması uzun süren ve birden fazla adımdan oluşan görevlere ağırlık verilerek geliştirildi. Modelin kendi ürettiği sonuçları kontrol etmesi, uzun bağlamları yönetmesi ve görev boyunca tutarlılığını koruması da geliştirme sürecinin önemli başlıkları arasında yer alıyor.
Bu yaklaşım, yapay zekânın yalnızca sohbet penceresinde soru-cevap yapan bir araç olmaktan çıkıp bir işi baştan sona gerçekleştiren “ajan” sistemlere doğru ilerlemesiyle de örtüşüyor. Özellikle yazılım geliştirme tarafında bir modelin kod üretmesi kadar, ürettiği kodu test etmesi, hatayı tespit etmesi ve farklı araçlar arasında geçiş yaparak görevi tamamlaması önem kazanıyor.
xAI, Grok 4.7’yi bu nedenle özellikle kodlama, profesyonel bilgi işleri ve çok adımlı görevler için öne çıkarıyor.
Kodlama testlerinde dikkat çeken artış
Grok 4.7’nin lansmanında en fazla öne çıkan alanlardan biri yazılım geliştirme oldu.
xAI’nin yayımladığı karşılaştırmalı sonuçlarda Grok 4.7, CursorBench 4.0 testinde yüzde 46,3 puan aldı. Aynı tabloda Grok 4.6’nın yüzde 40,4 seviyesinde kaldığı görüldü. Terminal-Bench 4.0 testinde ise yeni model yüzde 38 puana ulaşırken önceki sürüm yüzde 20,3’te kaldı. DeepSWE v1.1 sonucunda da Grok 4.7’nin yüzde 71 seviyesine ulaştığı, Grok 4.6’nın ise yüzde 65,2 puan aldığı açıklandı.
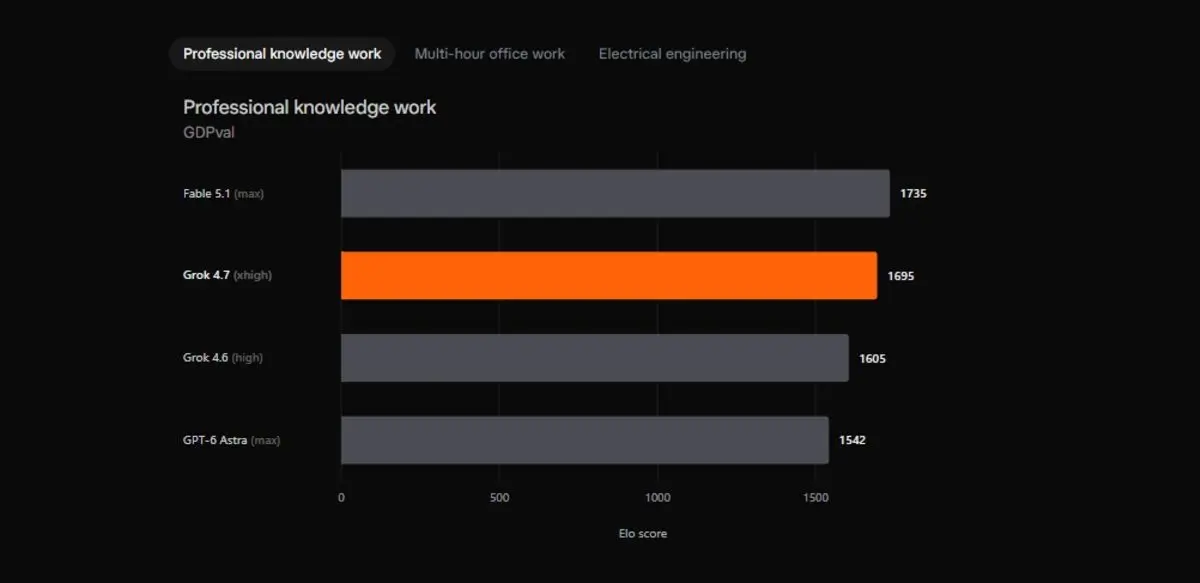
xAI’nin verileri yalnızca kodlama testleriyle sınırlı değil. Şirket, hukuk, klinik muhakeme, elektrik mühendisliği ve profesyonel ofis işlerine yönelik testlerde de Grok 4.7’nin önceki nesle göre ilerleme gösterdiğini belirtiyor. Örneğin Harvey Legal Agent Benchmark’ta yeni model yüzde 19,6, HealthBench Professional testinde yüzde 56,7 ve EEBench’te yüzde 64 seviyesinde sonuç açıkladı.
Burada önemli bir ayrıntı da sonuçların önemli bölümünün xAI tarafından açıklanan benchmark verileri olması. Dolayısıyla bu rakamlar modelin lansman performansını ortaya koyarken, farklı laboratuvarların aynı koşullarda yapacağı bağımsız testlerin sonuçlarıyla ayrıca değerlendirilmesi gerekiyor.
Saatler süren görevler için tasarlandı
Grok 4.7’deki en önemli değişikliklerden biri, modelin uzun süreli çalışma biçimine yönelik eğitim olarak gösteriliyor.
xAI, eğitim sırasında özellikle saatler sürebilecek problemleri içeren daha zor görevlerden yararlandığını belirtiyor. Bu durum, tek bir komutla kısa cevap üretmekten farklı bir kullanım alanına işaret ediyor. Örneğin bir yazılım projesindeki hatanın bulunması, kodun düzeltilmesi, testlerin çalıştırılması ve ortaya çıkan yeni sorunların tekrar ele alınması gibi birbirine bağlı görevlerde modelin süreci sürdürebilmesi hedefleniyor.
Şirket ayrıca Grok 4.7’nin Grok Bot altyapısını doğal biçimde anlayacak şekilde eğitildiğini ve bunun sohbet, genel bilgi çalışmaları, belge hazırlama ve sunum oluşturma gibi alanlarda da kullanılması amaçlandığını duyurdu.
500 bin tokenlık geniş bağlam penceresi
Grok 4.7’nin teknik özelliklerinden biri de 500 bin tokenlık bağlam penceresi.
xAI’nin dokümantasyonunda modelin metin ve görsel girdileri kabul ettiği, metin çıktı ürettiği ve 500 bin tokenlık bağlam kapasitesine sahip olduğu belirtiliyor. Reasoning özelliği bulunan modelde düşük, orta, yüksek ve xhigh olmak üzere farklı düşünme seviyeleri de destekleniyor. Varsayılan reasoning seviyesi ise “high” olarak tanımlanıyor.
Uzun bağlam desteği özellikle büyük kod tabanları, uzun dokümanlar ve birbirine bağlı dosyalarla çalışan kullanıcılar açısından önem taşıyor. Ancak daha geniş bağlam kapasitesinin tek başına her görevde daha iyi sonuç anlamına gelmediği, gerçek performansın kullanılan iş akışı ve token tüketimiyle birlikte değerlendirilmesi gerektiği de göz önünde bulunduruluyor.
Fiyat değişmedi ancak gerçek maliyet farklı olabilir
Grok 4.7’nin lansmanındaki dikkat çekici başlıklardan biri, xAI’nin modelin temel API fiyatını Grok 4.6 seviyesinde tutması oldu.
Standart fiyatlandırmada milyon giriş tokenı 2 dolar, milyon çıkış tokenı ise 6 dolar olarak açıklanıyor. 200 bin tokenın üzerindeki istemlerde daha yüksek fiyatlandırma uygulanıyor. Grok 4.7 Fast modeli ise standart fiyatın iki katı seviyesinde ücretlendiriliyor. xAI dokümanlarına göre Fast sürüm, genel API’ye açık bir model olarak değil, belirli platformlarda sunuluyor.
Ancak nominal token fiyatı, bir yapay zekâ modelinin gerçek kullanım maliyetini tek başına ortaya koymayabilir. VentureBeat’in lansman değerlendirmesinde de özellikle uzun ajan görevlerinde modelin ne kadar token tükettiği, kaç kez araç çağrısı yaptığı ve görevi kaç denemede tamamladığı gibi unsurların toplam maliyeti etkileyebileceğine dikkat çekildi.
Bu nedenle Grok 4.7’nin geliştiriciler açısından maliyet avantajı, yalnızca milyon token fiyatına bakılarak değil, belirli bir görevin başarıyla tamamlanması için harcanan toplam kaynak üzerinden değerlendirilecek.

Yeni güvenlik katmanı da beraberinde geldi
xAI, Grok 4.7 ile birlikte güvenlik mimarisini de yenilediğini açıkladı.
Şirket, yeni modelin jailbreak girişimlerine ve sakıncalı taleplere karşı önceki modellere göre daha güçlü direnç göstermesi amacıyla tamamen yeni bir güvenlik katmanı kullandığını bildiriyor. xAI ayrıca siber güvenlik ve biyolojik araştırmalar gibi hem faydalı hem de kötüye kullanıma açık alanlarda, zararlı talepleri sınırlandırırken meşru araştırma görevlerinde kullanılabilirliği korumaya odaklandığını belirtiyor.
Şirket tarafından paylaşılan güvenlik sonuçlarında LatchBio’nun biyogüvenlik testinde yüzde 62,4’lük bir skor veriliyor. Bu veriler de diğer benchmark sonuçları gibi şirket açıklamalarına dayanıyor ve daha geniş bağımsız değerlendirmelerle birlikte ele alınması gerekiyor.
Grok 4.7 nerelerde kullanılabilecek?
Yeni model lansmanla birlikte Cursor, Grok Build ve xAI API üzerinden kullanıma açıldı. Ayrıca üçüncü taraf kodlama araçları, model yönlendiricileri ve çeşitli bulut platformlarında da erişim sağlanıyor.
Grok 4.7’nin GitHub Copilot tarafındaki dağıtımı da ayrıca başlatıldı. GitHub, modelin Copilot Pro, Pro+, Max, Business ve Enterprise paketlerine kademeli şekilde sunulacağını açıkladı. VS Code, Visual Studio, Copilot CLI, GitHub Copilot cloud agent, JetBrains, Xcode ve Eclipse gibi farklı geliştirme ortamlarında model seçeneğinin kullanılabilmesi planlanıyor.
Bu durum Grok 4.7’nin yalnızca xAI’nin kendi ürünlerinde değil, yazılım geliştirme ekosisteminin farklı noktalarında da kullanılmasını mümkün kılıyor.
Grok 4.7’nin önündeki asıl sınav kullanımda olacak
Grok 4.7’nin duyurusu, yapay zekâ modellerindeki yarışın yalnızca daha yüksek benchmark puanlarına değil, uzun süreli görevleri daha istikrarlı şekilde tamamlayabilmeye doğru kaydığını gösteriyor.
xAI yeni modelinde kodlama, uzun bağlam yönetimi, profesyonel iş akışları, kendi çıktısını kontrol etme ve güvenlik alanlarına odaklanıyor. Grok 4.7’nin önceki sürüme kıyasla birçok testte daha yüksek sonuçlar açıklaması dikkat çekerken, bağımsız değerlendirmelerde ise token tüketimi ve görev başına gerçek maliyet gibi farklı ölçütlerin de hesaba katılması gerektiği görülüyor.
21 Eylül 2026 itibarıyla başlayan Grok 4.7 dönemi, özellikle yazılım geliştiriciler ve uzun süren profesyonel iş akışlarında yapay zekâ kullanan ekipler açısından yeni bir dönemin başlangıcını işaret ediyor. Modelin gerçek dünyadaki performansı ise benchmark tablolarından çok, günlük kullanımda karmaşık işleri ne kadar az insan müdahalesiyle, ne kadar istikrarlı ve hangi toplam maliyetle tamamlayabildiği üzerinden daha net ortaya çıkacak.